Temps de lecture estimé : 7 minutes
Points clés à retenir
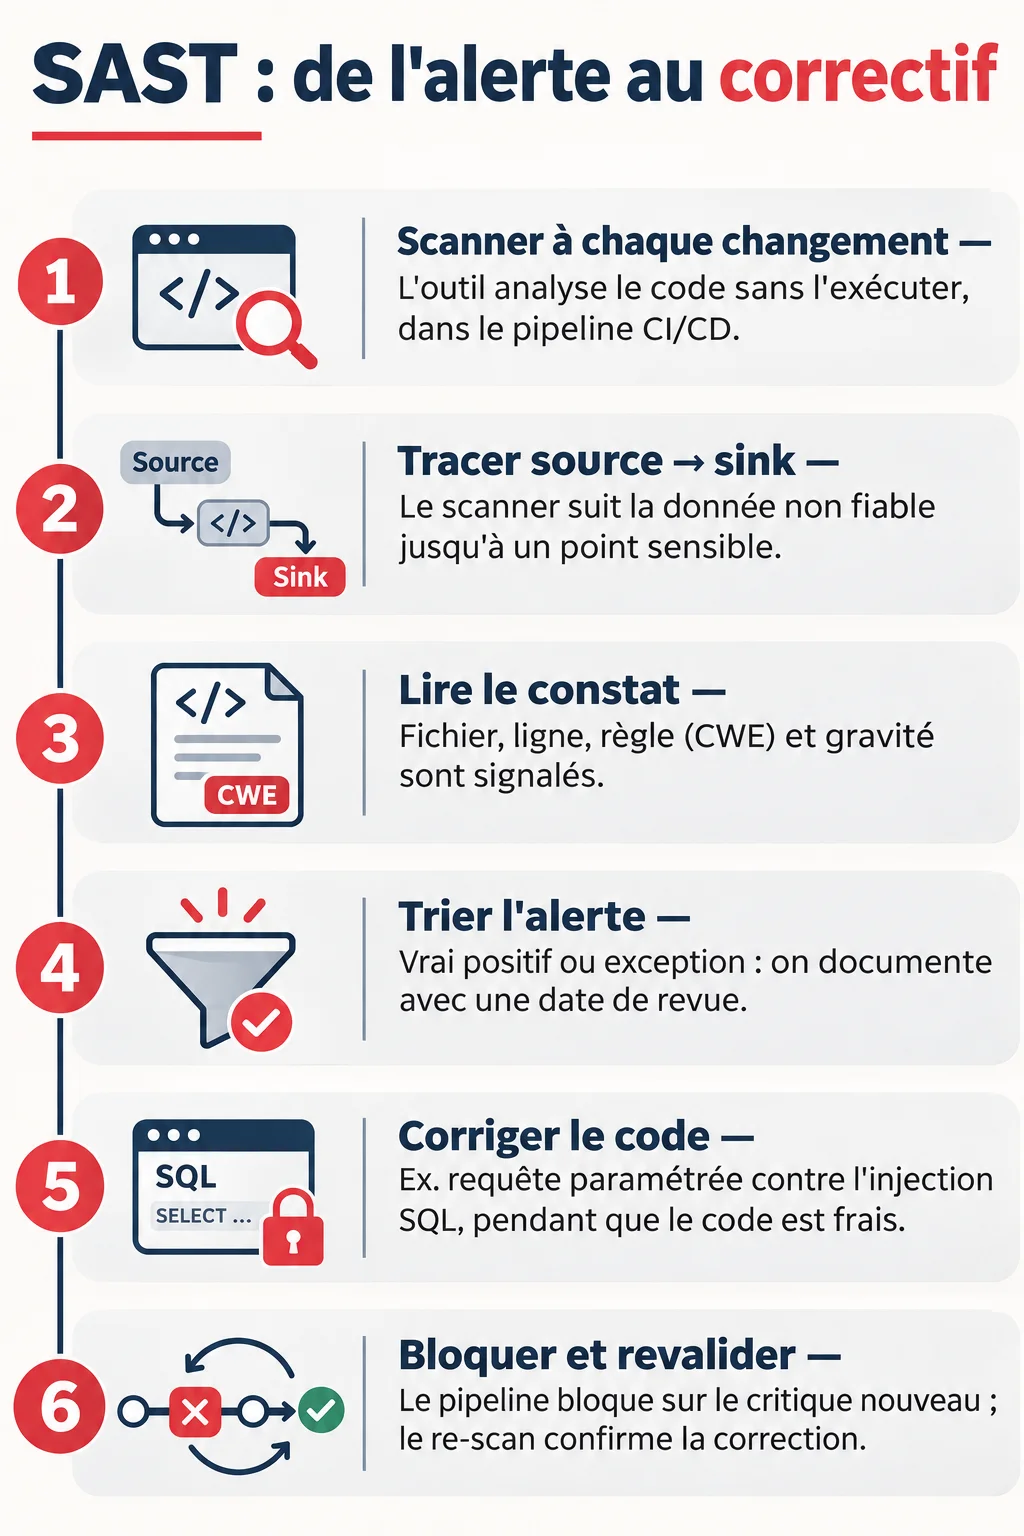
- Le SAST analyse le code sans l’exécuter et signale fichier, ligne, règle et gravité.
- Il ne voit ni la configuration, ni l’exécution, ni les dépendances : combinez SAST, SCA et DAST.
- Bloquez le pipeline seulement sur les gravités critiques du code nouveau.
- Une alerte SAST est à trier : documentez chaque exception avec une date de revue.
- Scannez à chaque changement et épinglez les versions des outils du pipeline.
Qu’est-ce que le SAST et comment analyse-t-il le code ?
Le SAST sécurité code désigne l’analyse statique du code source, du bytecode ou des binaires, réalisée sans exécuter l’application. L’outil lit le programme comme un texte structuré et signale les endroits où une faille est possible. C’est un test en boîte blanche : il voit tout le code.
Pour bien comprendre la démarche, voici le SAST dans sa version la plus simple : un scanner qui suit le chemin d’une donnée à travers le programme.
De la source au sink
Le scanner repère d’abord les sources, c’est-à-dire les points où une donnée non fiable entre : un paramètre d’URL, un champ de formulaire, un en-tête HTTP. Il suit ensuite cette donnée de variable en variable. Il cherche enfin un sink, un endroit sensible comme une requête SQL ou une commande système.
Prenons un exemple en Python :
- la source :
user = request.args["nom"] - le sink :
cursor.execute("SELECT * FROM clients WHERE nom = '" + user + "'")
Aucune validation n’existe entre les deux. Le scanner déclare donc un chemin de contamination, soit une injection SQL potentielle.
À quoi ressemble un résultat
Un constat SAST contient en général quatre informations : le fichier, la ligne, la règle déclenchée et la gravité. Par exemple : app/clients.py, ligne 42, règle « injection SQL » (CWE-89), gravité haute.
Le correctif consiste à passer à une requête paramétrée : cursor.execute("SELECT * FROM clients WHERE nom = %s", (user,)). Au scan suivant, le chemin source-sink est neutralisé et l’alerte disparaît. Cette boucle courte est ce qui fait la valeur du shift-left : le développeur corrige pendant qu’il a encore le code en tête.
Quelles failles le SAST détecte-t-il, et lesquelles lui échappent ?
Le SAST repère les défauts visibles dans le code que vous écrivez. Les résultats se rattachent aux référentiels OWASP Top 10 et SANS/CWE Top 25, ce qui facilite la priorisation.
- injections SQL et de commandes
- failles XSS
- secrets codés en dur (mots de passe, clés d’API)
- cryptographie faible
- désérialisation non sécurisée
Ses angles morts sont tout aussi importants. Il ne voit pas les erreurs de configuration d’un serveur, ni les comportements à l’exécution, ni les failles de logique métier. Il ne détecte pas non plus les 0-days.
Deux limites pratiques s’ajoutent. Chaque outil ne couvre qu’une liste de langages de programmation, et la qualité des règles varie d’un langage à l’autre. Enfin, l’analyse porte sur un modèle du programme, donc elle produit des faux positifs.
Une nuance sur le périmètre : certains éditeurs annoncent que le SAST couvre aussi les dépendances. Dans ma pratique, je range ces dernières côté SCA, et je vérifie toujours ce que mon outil fait réellement.
SAST, DAST, SCA : quelles différences et comment les combiner ?
Ces trois approches ne se remplacent pas. Elles regardent des zones différentes du même logiciel.
| Approche | Ce qu’elle examine | Moment | Ce qu’elle apporte |
|---|---|---|---|
| SAST | Le code que vous écrivez | Dès l’écriture, sans exécution | La ligne fautive |
| DAST | L’application en fonctionnement | Sur une version déployée en test | Les failles visibles de l’extérieur |
| SCA | Les bibliothèques importées | À chaque changement de dépendance | Les vulnérabilités connues |
Ce que seul le SCA voit
Une étude Synopsys de 2024 indique que 84 % des bases de code analysées contiennent au moins une vulnérabilité connue dans leurs dépendances open source. Ce chiffre concerne le SCA, pas le SAST. Une application moderne tire en outre 70 à 90 % de son code de composants open source, d’après piirates.fr.
Log4Shell en est l’illustration. Publiée en décembre 2021 avec un score CVSS de 10.0, cette faille se trouvait dans une bibliothèque, pas dans le code des équipes qui l’utilisaient. Un SAST n’avait rien à signaler.
Ce que personne ne voit seul
Le DAST complète le SAST en testant l’application vivante, donc en voyant la configuration et le comportement à l’exécution. Le pentest ajoute le raisonnement humain, utile pour la logique métier. Côté classement, le CWE Top 25 2025 de MITRE s’appuie sur 39 080 enregistrements CVE, et l’OWASP Top 10:2025 place les défaillances de la chaîne d’approvisionnement logicielle en A03.
Intégrer le SAST dans le cycle de développement et la CI/CD
Le bon réflexe consiste à scanner à plusieurs niveaux, du plus rapide au plus complet.
- Dans l’IDE : un retour immédiat pendant l’écriture.
- Au commit : un contrôle léger, surtout pour les secrets.
- À la pull request : un scan incrémental sur les fichiers modifiés.
- Dans le pipeline : un scan complet avant la fusion ou la livraison.
Des quality gates par criticité
Bloquer le pipeline sur toutes les alertes paralyse les équipes, qui finissent par contourner l’outil. Je recommande une règle graduée :
- gravité critique ou haute sur du code nouveau : le build échoue
- gravité moyenne : un ticket est créé, sans blocage
- gravité basse : l’alerte reste consultable dans le rapport
Commencez en mode « avertissement » deux ou trois semaines, le temps de mesurer le bruit. Puis activez le blocage uniquement sur le code nouveau, pas sur l’existant.
Fréquence et versions épinglées
Un rapport SAST est un instantané. Il vieillit à chaque commit, donc un scan unique ne prouve rien. Les scans doivent tourner à chaque changement.
Pensez aussi à épingler les versions des outils et des actions de votre pipeline. Une version flottante peut changer les règles du jour au lendemain, ou introduire du code non maîtrisé dans votre chaîne de build. Cela rejoint les pratiques de codage de base : reproductibilité et traçabilité.
Gérer les faux positifs et le bruit des alertes
Le SAST ne lance jamais le programme. Il raisonne sur un modèle, et ne sait pas toujours qu’une validation en amont, dans un autre module, neutralise la donnée. Une alerte est donc un signal à vérifier, pas une vulnérabilité confirmée.
Voici le tri que j’applique :
- Vérifier que la source est contrôlable par un utilisateur.
- Suivre le chemin jusqu’au sink et chercher une validation ou un échappement.
- Classer : vrai positif, faux positif ou risque accepté.
- Corriger les vrais positifs par ordre de gravité.
Pour un faux positif avéré, documentez l’exception avec une annotation dans le code. Elle doit porter la justification, le nom de l’approbateur et une date de revue. Une exception sans date devient vite une faille oubliée.
Enfin, ajustez les règles plutôt que de multiplier les exceptions. Si la même règle produit dix faux positifs dans votre framework, désactivez-la localement ou affinez-la. Le bruit baisse, et la confiance des développeurs remonte.
Comment choisir un outil SAST
Chez moi, la règle a toujours été simple : on choisit un outil que les développeurs utiliseront vraiment. Voici mes critères, dans l’ordre :
- Langages et frameworks de votre stack, sans lesquels le reste est inutile.
- Intégration à l’IDE, à la CI/CD et à votre dépôt de code.
- Qualité des règles et possibilité de les personnaliser.
- Aide à la remédiation : un exemple de correctif vaut mieux qu’un simple code d’erreur.
Côté offre, on trouve des outils open source comme Semgrep ou SonarQube, et des solutions commerciales plus intégrées. L’open source permet de tester sans engagement, ce qui est précieux sur un projet pilote.
Méfiez-vous des études publiées par les éditeurs. L’enquête JFrog de 2024 auprès de 1 200 professionnels porte sur la sécurité de la chaîne d’approvisionnement logicielle, pas sur le SAST seul. Faites plutôt un essai sur votre propre code.
Les erreurs les plus fréquentes de mise en œuvre
- Scanner sans trier : des centaines d’alertes brutes noient les développeurs.
- Confondre présence d’une vulnérabilité et exploitabilité réelle.
- Traiter le SAST comme un audit ponctuel au lieu d’un contrôle continu.
- Croire que SAST et SCA suffisent à garantir la sécurité applicative.
La dernière erreur est la plus coûteuse. Selon Radware, 98 % des organisations déclarent avoir subi des attaques visant leurs applications web et mobiles. Ces attaques exploitent aussi la configuration, l’exécution et la logique métier, que le SAST ne voit pas.
Pour ma part, je vois le SAST comme un maillon de la chaîne, aux côtés du SCA, de la détection de secrets, du DAST et du pentest. Bien réglé et intégré au pipeline, il reste le plus rapide pour corriger les failles de votre propre code. C’est ce qui rend le SAST sécurité code indispensable, à condition de ne pas lui demander plus qu’il ne peut voir.