Temps de lecture estimé : 6 minutes
Points clés à retenir
- sed traite le texte ligne par ligne sans éditeur interactif
- Le flag g remplace toutes les occurrences, pas seulement la première
- Toujours tester sans -i avant modification destructive
- La syntaxe de -i diffère entre GNU/Linux et BSD/macOS
- -i.bak sauvegarde le fichier original avant écriture
Qu’est-ce que la commande sed sous Linux
La commande sed Linux sert à modifier du texte directement depuis le terminal, sans ouvrir aucun éditeur. Le nom veut dire stream editor, et son fonctionnement traite un fichier ligne par ligne, en appliquant à chacune la ou les instructions qu’on lui donne.
Contrairement à un éditeur interactif comme nano ou vim, sed ne montre rien à l’écran par défaut. Il lit, transforme, écrit. Cette logique de traitement en flux est ce qui fait sa puissance dans les scripts.
sed appartient au paquetage GNU Core Utilities (Coreutils), présent par défaut sur quasi toutes les distributions Linux. Pas d’installation à prévoir : dans mon expérience, il est déjà là sur n’importe quel serveur Debian ou Ubuntu fraîchement monté.
L’outil existe depuis les années 1970, hérité d’ed, l’un des tout premiers éditeurs Unix. Cette ancienneté explique une syntaxe parfois austère, mais aussi une stabilité que peu d’outils modernes peuvent revendiquer.
Syntaxe de base de sed
La structure générale tient en une ligne : sed [options] ‘commande’ fichier. Les guillemets simples protègent l’expression des interprétations du shell, un réflexe à prendre dès le départ.
La commande la plus utilisée est s, pour substitute. Elle repose sur des délimiteurs, en général le slash, qui séparent le motif recherché du texte de remplacement : s/ancien/nouveau/.
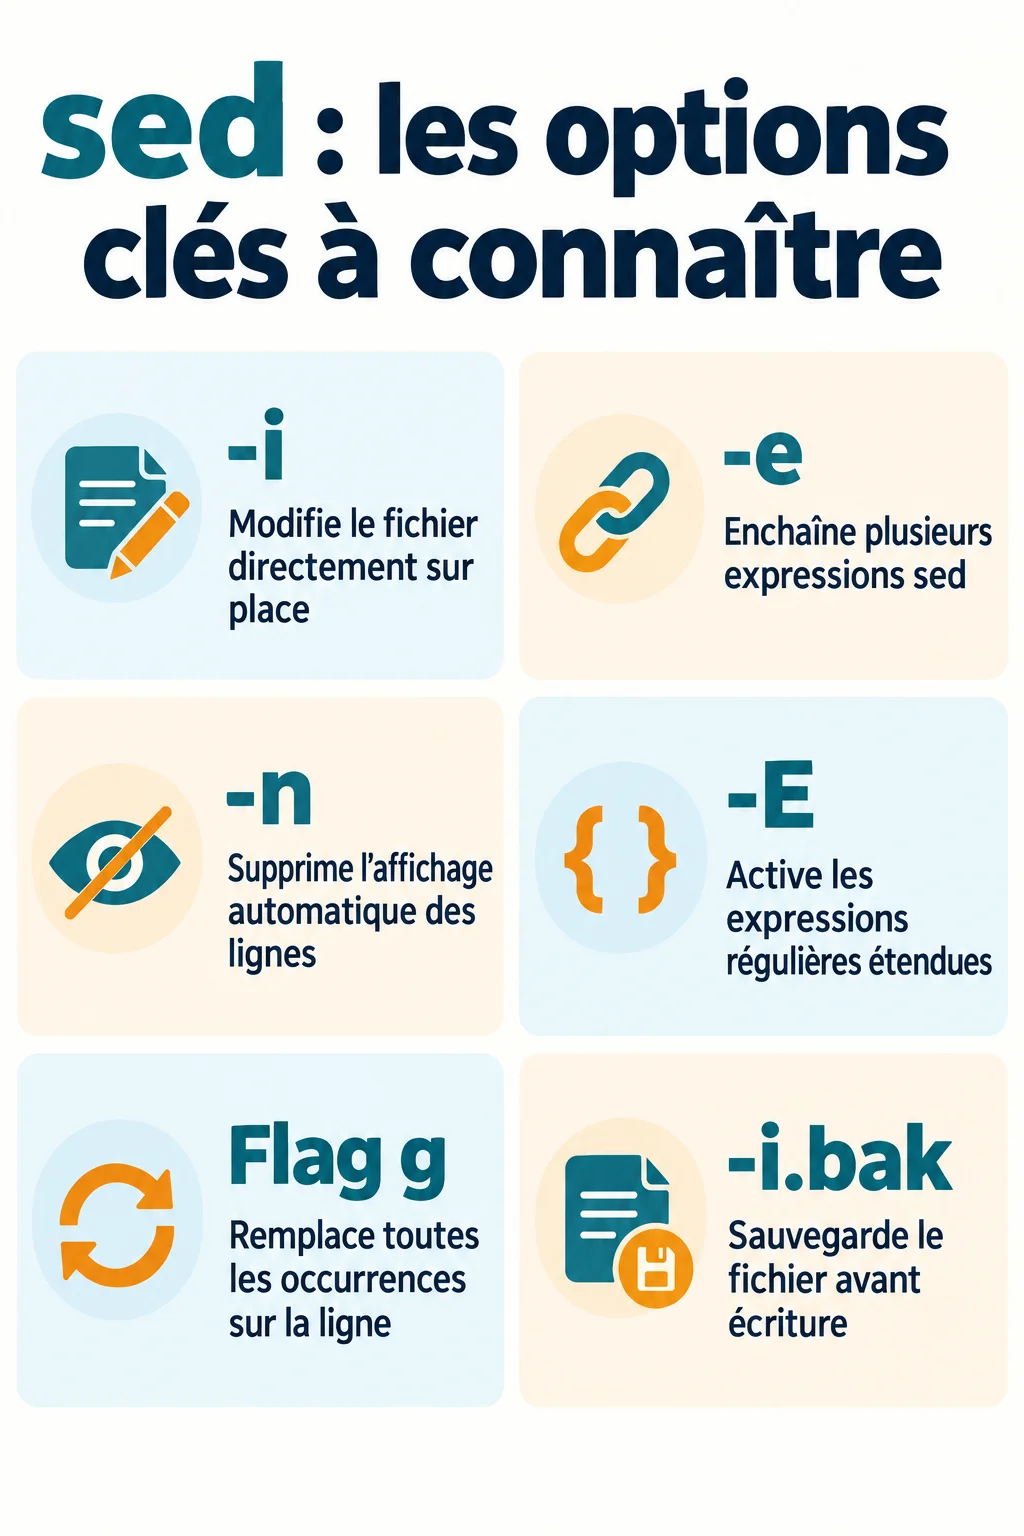
- -i : modifie le fichier sur place au lieu d’afficher le résultat
- -e : permet d’enchaîner plusieurs expressions sed
- -n : supprime l’affichage automatique, utile avec la commande p
- -E : active les expressions régulières étendues, plus lisibles
Chez moi, la règle a toujours été simple : je teste sans -i avant de modifier quoi que ce soit sur place.
Substituer du texte avec sed
Pour remplacer un mot par un autre dans un fichier, la syntaxe est sed 's/vieux/neuf/' fichier.txt. Par défaut, sed ne remplace que la première occurrence trouvée sur chaque ligne.
C’est un point mal compris des débutants. Si le mot apparaît trois fois sur la même ligne, une seule sera changée sans le flag adapté.
Pour remplacer toutes les occurrences, on ajoute le flag g en fin de commande : sed 's/vieux/neuf/g' fichier.txt. C’est la version que j’utilise dans 90 % de mes scripts de nettoyage.
Il est aussi possible d’injecter une variable Bash dans une commande sed, ce qui ouvre la porte à des remplacements dynamiques : sed "s/$ancien/$nouveau/g" fichier.txt. Les doubles guillemets sont ici indispensables pour que Bash interprète la variable avant de la passer à sed.
Supprimer des lignes avec sed
sed sait aussi effacer des lignes entières, avec la commande d (delete). On peut cibler un numéro précis : sed '3d' fichier.txt supprime la troisième ligne.
Une plage de lignes se cible avec une virgule, par exemple sed '2,5d' fichier.txt pour retirer les lignes 2 à 5. On peut aussi filtrer par expression régulière plutôt que par numéro.
- Supprimer les lignes vides :
sed '/^$/d' fichier.txt - Supprimer les lignes de commentaire commençant par # :
sed '/^#/d' fichier.txt - Supprimer une plage entre deux motifs :
sed '/DEBUT/,/FIN/d' fichier.txt
Un cas pratique fréquent : nettoyer un fichier de configuration bourré de commentaires avant de l’archiver. La combinaison des deux dernières commandes ci-dessus fait le travail en une seule ligne.
Afficher et filtrer des lignes avec sed
Avec l’option -n, sed n’affiche plus rien automatiquement. Il faut alors demander explicitement l’affichage avec la commande p (print) : sed -n '4p' fichier.txt affiche uniquement la ligne 4.
Pour visualiser ce mécanisme en pratique, cette vidéo de benlinux montre plusieurs exemples concrets de filtrage de lignes avec sed.
On peut aussi extraire un bloc entier entre deux motifs : sed -n '/DEBUT/,/FIN/p' fichier.txt. C’est utile pour isoler une section précise d’un gros fichier de log.
La différence avec grep tient à la finalité. grep sert à chercher et afficher des lignes correspondant à un motif, sed sert à transformer le contenu. Les deux se complètent souvent dans un même pipeline.
Insérer, ajouter et remplacer des lignes entières
Trois commandes permettent d’agir sur des lignes entières plutôt que sur du texte à l’intérieur. La commande a (append) ajoute une ligne après celle ciblée, la commande i (insert) l’ajoute avant.
La commande c (change) remplace complètement une ligne par une autre : sed '3c\Nouvelle ligne' fichier.txt.
Ces trois commandes forment, avec s, d et p, la base structurante de sed. Un cas d’usage que je rencontre souvent : modifier un fichier de configuration serveur pour activer ou désactiver une directive sans ouvrir vim, directement depuis un script de déploiement.
sed dans les scripts Bash et le traitement en masse
sed prend tout son sens dans une boucle for, pour appliquer la même transformation à plusieurs fichiers d’un coup :
for f in *.txt; do
  sed -i 's/ancien/nouveau/g' "$f"
done
On peut aussi s’en servir pour renommer des fichiers en masse, en combinant sed avec mv dans une boucle, pour retirer un préfixe ou changer une extension sur toute une série.
Avant toute modification en masse avec -i, je fais systématiquement un essai sans cette option pour vérifier le résultat affiché à l’écran.
L’option -i.bak crée une copie de sauvegarde du fichier original avant modification sur place : sed -i.bak 's/ancien/nouveau/g' fichier.txt. Le fichier fichier.txt.bak conserve la version d’origine, un filet de sécurité que je recommande sur tout script destiné à tourner en production.
Différences entre GNU sed et BSD/macOS
C’est le piège de portabilité le plus fréquent que je croise en revoyant des scripts d’équipe. Sous GNU/Linux, l’option -i s’utilise sans argument : sed -i 's/a/b/' fichier.txt.
Sous BSD ou macOS, cette même commande échoue, car -i exige un argument obligatoire, même vide : sed -i '' 's/a/b/' fichier.txt. Un script écrit et testé sur Linux plantera donc tel quel sur un Mac.
| Plateforme | Syntaxe de -i |
|---|---|
| GNU/Linux | sed -i ‘s/a/b/’ fichier |
| BSD/macOS | sed -i » ‘s/a/b/’ fichier |
GNU sed propose aussi des extensions non portables pour la conversion de casse : \U met en majuscules, \L en minuscules, \u et \l ne changent qu’un seul caractère, et \E ferme la conversion. Ces séquences n’existent pas sur sed POSIX ni sur BSD.
Autre contrainte technique à connaître : la commande y (translittération) exige impérativement le même nombre de caractères dans l’ensemble source et l’ensemble destination, sous peine d’erreur.
Avant d’écrire un script destiné à circuler sur plusieurs environnements, je vérifie toujours la version installée avec sed --version. C’est un réflexe de deux secondes qui évite des heures de débogage sur un serveur distant où la commande sed Linux se comporte différemment de mon Mac.